Quando preciso decodificar JWT em JavaScript, tento manter o código pequeno, mas não tão pequeno a ponto de esconder os erros importantes. Dividir a string por ponto e chamar atob() pode funcionar em exemplos ASCII simples; para uma implementação de depuração mais confiável, também preciso tratar Base64URL, UTF-8, prefixos Bearer e JSON inválido.
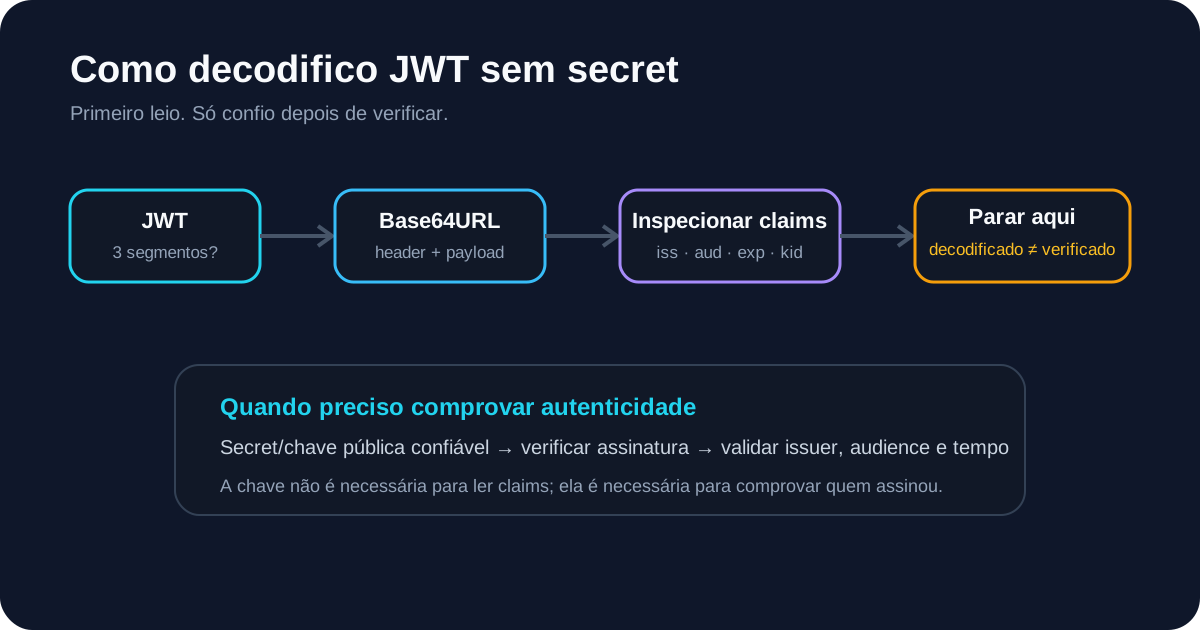
Minha primeira regra continua a mesma: este código serve para ler cabeçalho e payload. Ele não verifica a assinatura. Se eu preciso provar autenticidade, passo para uma biblioteca/implementação de verificação com uma chave que a aplicação realmente confia.
Para uma inspeção rápida sem escrever código, uso o Decodificador JWT. Abaixo está o raciocínio que aplico quando quero fazer o mesmo em JavaScript.
A estrutura que espero receber
Um JWT/JWS assinado normalmente tem:
header.payload.signature
Cada um dos dois primeiros segmentos é Base64URL de bytes UTF-8 que normalmente representam JSON.
Por isso, meu fluxo é:
entrada
  ↓
remover Authorization: Bearer / Bearer
  ↓
confirmar 3 segmentos
  ↓
Base64URL → bytes
  ↓
UTF-8 → texto
  ↓
JSON.parse
Se a entrada tiver cinco segmentos, considero a possibilidade de JWE e não tento fingir que o segundo segmento é um payload JWT legível.
Primeiro: normalizo o Bearer token
Muitas vezes o valor vem direto de um header HTTP:
Authorization: Bearer eyJhbGciOi...
ou apenas:
Bearer eyJhbGciOi...
Antes de dividir por ponto, removo esses prefixos:
function normalizeJwtInput(input) {
  return input
    .trim()
    .replace(/^Authorization:\s*Bearer\s+/i, "")
    .replace(/^Bearer\s+/i, "")
    .trim();
}
Isso evita um diagnóstico falso de “Base64 inválido” causado apenas pelo texto Bearer no começo da string.
Base64URL não é o mesmo texto que Base64 tradicional
JWT usa Base64URL. A diferença mais visível é:
- no lugar de +
_ no lugar de /
padding = normalmente omitido
Por isso normalizo antes de atob():
function base64UrlToBytes(segment) {
  const base64 = segment
    .replace(/-/g, "+")
    .replace(/_/g, "/");

  const padded = base64.padEnd(
    base64.length + ((4 - (base64.length % 4)) % 4),
    "="
  );

  const binary = atob(padded);
  return Uint8Array.from(binary, (char) => char.charCodeAt(0));
}
Usar atob(segment) diretamente costuma funcionar apenas enquanto os caracteres e o padding não expõem a diferença.
Depois converto os bytes em UTF-8
Este ponto importa para payloads que contêm nomes, acentos, emoji ou outros caracteres fora de ASCII.
Uso TextDecoder:
function decodeBase64UrlUtf8(segment) {
  const bytes = base64UrlToBytes(segment);
  return new TextDecoder("utf-8", { fatal: true }).decode(bytes);
}
Depois faço o parse:
function decodeJsonSegment(segment) {
  return JSON.parse(decodeBase64UrlUtf8(segment));
}
Se o texto não for UTF-8 válido ou não for JSON válido, prefiro receber um erro explícito em vez de continuar com dados corrompidos.
Uma função completa para decodificar o JWT
Uma versão pequena que uso como referência de leitura é:
function decodeJwt(input) {
  const token = normalizeJwtInput(input);
  const parts = token.split(".");

  if (parts.length === 5) {
    throw new Error("Parece um JWE criptografado de 5 segmentos.");
  }

  if (parts.length !== 3) {
    throw new Error("Um JWT assinado deve ter 3 segmentos.");
  }

  const [headerSegment, payloadSegment, signature] = parts;

  if (!headerSegment || !payloadSegment) {
    throw new Error("Cabeçalho ou payload ausente.");
  }

  return {
    header: decodeJsonSegment(headerSegment),
    payload: decodeJsonSegment(payloadSegment),
    signature
  };
}
Uso isso para inspeção e depuração. Não chamaria essa função de verifyJwt, porque ela não faz nenhuma operação criptográfica.
Como leio o claim exp em JavaScript
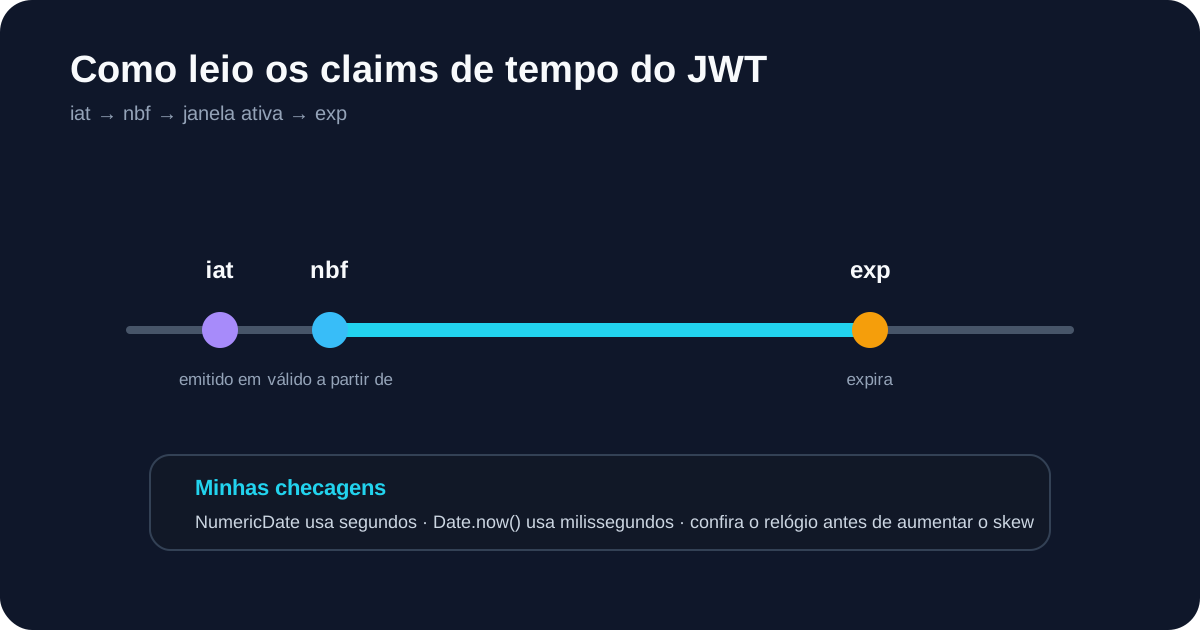
Um erro muito comum é misturar segundos e milissegundos.
JWT NumericDate usa segundos desde o Unix epoch. Date.now() retorna milissegundos.
Então:
const expiresAt = payload.exp * 1000;
const isExpired = Date.now() >= expiresAt;
E para exibir uma data:
const expiration = new Date(payload.exp * 1000);
console.log(expiration.toISOString());
Nunca comparo diretamente um exp típico de 10 dígitos com Date.now() sem ajustar a unidade.
Quando só quero o resultado e não o código, uso o Verificador de Expiração JWT, que também mostra iat e nbf.
Como trato claims ausentes
Não escrevo código supondo que todo JWT terá exp, iss, aud ou kid.
Por exemplo:
if (typeof payload.exp === "number") {
  const expired = Date.now() >= payload.exp * 1000;
}
Uma claim ausente pode ser inválida para o perfil da sua aplicação, mas isso é uma decisão de validação, não uma falha automática de decodificação.
É por isso que mantenho leitura e política separadas.
Como lido com aud sendo string ou array
A RFC 7519 permite que aud apareça como uma string ou, em casos gerais, como uma lista de strings.
Eu normalizo para um array quando preciso comparar:
function audienceValues(aud) {
  if (typeof aud === "string") return [aud];
  if (Array.isArray(aud)) {
    return aud.filter((value) => typeof value === "string");
  }
  return [];
}
Isso evita validadores caseiros que aceitam apenas um dos formatos e geram um audience mismatch falso.
Browser versus Node.js
No navegador, atob() e TextDecoder estão disponíveis nas plataformas modernas.
No Node.js, posso usar Buffer:
const json = Buffer
  .from(payloadSegment, "base64url")
  .toString("utf8");

const payload = JSON.parse(json);
Mesmo assim, mantenho a mesma separação mental: Buffer.from(..., "base64url") decodifica; não verifica a assinatura.
Se estou implementando autenticação real no backend, prefiro uma biblioteca JOSE/JWT madura que execute verificação, restrição de algoritmo e validação de claims, em vez de montar criptografia manualmente.
Por que não uso JSON.parse(atob(payload)) como solução final
Este one-liner aparece muito em snippets:
JSON.parse(atob(token.split(".")[1]));
Ele é atraente, mas esconde várias suposições:
- o token tem exatamente a forma esperada;
- não veio com
Bearer; - o segmento é compatível com Base64 tradicional;
- padding não será problema;
- o JSON contém apenas caracteres simples;
- o payload é JSON válido;
- não é um JWE;
- ninguém interpretará “parseou” como “assinatura válida”.
Para um console rápido em um token controlado, pode servir. Para uma ferramenta ou utilitário reutilizável, considero frágil demais.
Como verifico a assinatura depois de decodificar
Depois de ler:
{
  "alg": "RS256",
  "kid": "key-42"
}
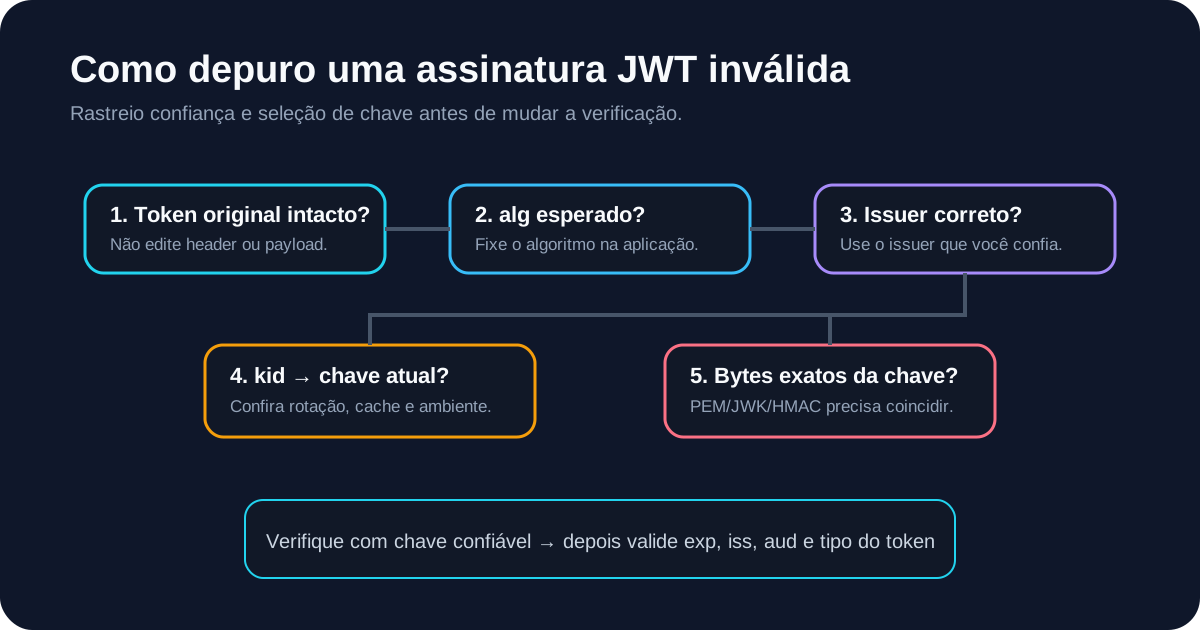
não importo automaticamente uma chave indicada pelo próprio token e confio nela.
Primeiro identifico qual emissor a aplicação confia e qual é a fonte confiável de chaves. Depois seleciono a chave apropriada e verifico a assinatura sobre os bytes originais de:
base64url(header).base64url(payload)
Se tenho uma chave PEM/secret, uso o Verificador de Assinatura JWT. Se o emissor usa JWKS, uso o Validador JWKS.
Erros que quero mostrar claramente
Em uma ferramenta de desenvolvimento, tento diferenciar:
- entrada vazia;
- quantidade de segmentos errada;
- JWE de cinco segmentos;
- Base64URL inválido;
- bytes que não são UTF-8 válido;
- cabeçalho sem JSON válido;
- payload sem JSON válido;
- JSON que não é objeto.
Misturar tudo em “invalid token” torna a depuração muito mais lenta.
Foi por isso que o JWTDecoder.tools passou a usar códigos internos estáveis de erro e só depois transformar cada um em uma mensagem localizada para o usuário.
Meu checklist para decodificar JWT em JavaScript
Quando escrevo meu próprio decoder de inspeção, verifico:
- Remoção segura de
Authorization: BearereBearer. - Distinção entre JWT/JWS de 3 segmentos e JWE de 5.
- Conversão Base64URL correta, inclusive padding.
- Conversão dos bytes com UTF-8.
JSON.parsecom tratamento de erro.exp,iatenbftratados como segundos.audaceitando string e array.- Nenhuma mensagem sugerindo que decodificação equivale a assinatura válida.
Se a finalidade é autenticação de produção, o passo seguinte não é adicionar mais snippets ao decoder. É usar uma implementação de verificação confiável, com algoritmo permitido, chave ligada ao emissor e validação explícita de iss, aud, exp e demais regras do sistema.
Para mim, essa é a fronteira correta: JavaScript consegue decodificar JWT com poucas linhas; autenticar um JWT exige muito mais do que decodificar Base64URL.