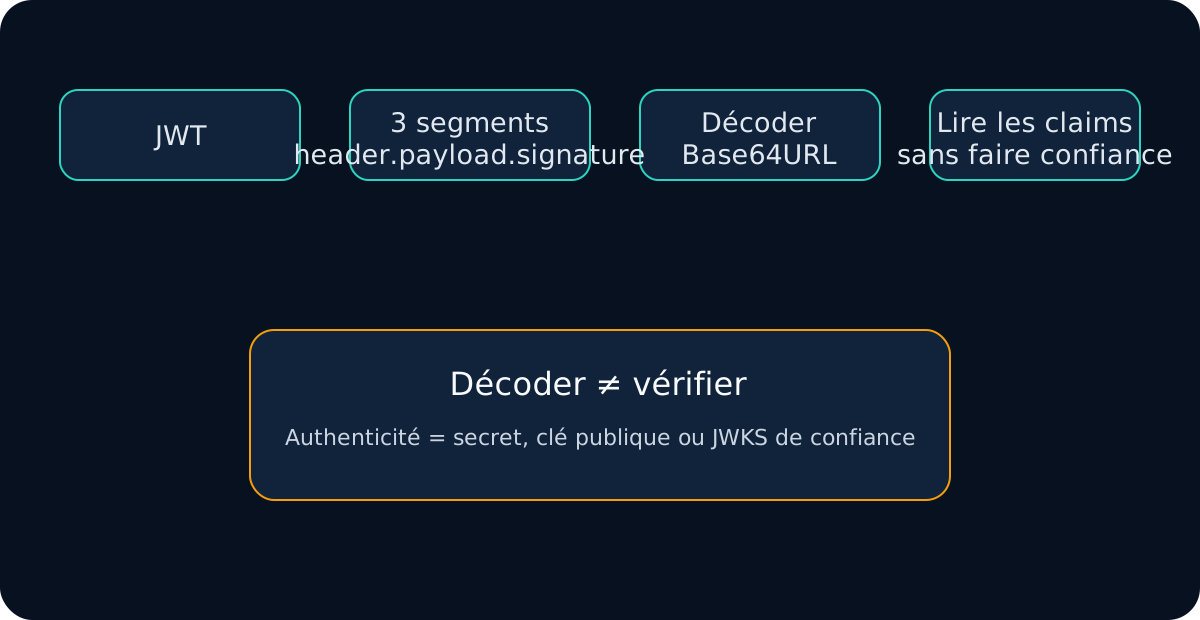
Quand je dois décoder un JWT en JavaScript, je fixe une règle avant d'écrire le code : le décodage sert à inspecter, pas à authentifier. Un JSON.parse() réussi ne prouve ni l'authenticité ni l'acceptabilité du token.
Pour une inspection rapide, j'utilise le JWT Decoder. Dans une application, je suis six étapes explicites.
Les six étapes que j'utilise
- Retirer
BearerouAuthorization: Bearer. - Vérifier le nombre de segments.
- Convertir Base64URL en bytes correctement.
- Décoder les bytes en UTF-8.
- Parser JSON avec des erreurs distinctes.
- Inspecter
expet les claims, tout en séparant la signature.
1. Normaliser l'entrée
function normalizeJwtInput(input) {
  return input
    .trim()
    .replace(/^authorization\s*:\s*bearer\s+/i, "")
    .replace(/^bearer\s+/i, "")
    .trim()
    .replace(/^['"]|['"]$/g, "");
}
Je veux que le reste du decoder travaille avec une seule représentation : le compact token.
2. Compter les segments avant de décoder
Un JWS signé est généralement :
header.payload.signature
Un JWE compact est normalement composé de cinq segments.
function splitSignedJwt(input) {
  const token = normalizeJwtInput(input);
  const parts = token.split(".");

  if (parts.length === 5) throw new Error("Ce token ressemble à un JWE chiffré");
  if (parts.length !== 3) throw new Error(`3 segments attendus, ${parts.length} reçus`);
  return parts;
}
Je préfère cela à lire aveuglément token.split('.')[1].
3. Traiter Base64URL comme Base64URL
Le JWT utilise l'alphabet URL-safe et omet souvent le padding.
function base64UrlToBytes(segment) {
  const base64 = segment.replace(/-/g, "+").replace(/_/g, "/");
  const padded = base64.padEnd(
    base64.length + ((4 - (base64.length % 4)) % 4),
    "="
  );
  const binary = atob(padded);
  return Uint8Array.from(binary, c => c.charCodeAt(0));
}
atob() ne résout pas le problème UTF-8 à lui seul.
4. Décoder UTF-8 avant JSON
Les payloads ASCII peuvent masquer longtemps une mauvaise implémentation. Dès qu'un nom ou une valeur localisée contient des caractères non ASCII, les raccourcis cassent.
function decodeJwtJson(segment, label) {
  let text;
  try {
    const bytes = base64UrlToBytes(segment);
    text = new TextDecoder("utf-8", { fatal: true }).decode(bytes);
  } catch {
    throw new Error(`${label} n'est pas du Base64URL/UTF-8 valide`);
  }

  let value;
  try {
    value = JSON.parse(text);
  } catch {
    throw new Error(`${label} ne contient pas un JSON valide`);
  }

  if (!value || typeof value !== "object" || Array.isArray(value)) {
    throw new Error(`${label} doit être un objet JSON`);
  }
  return value;
}
Séparer les erreurs d'encodage des erreurs JSON accélère mon diagnostic.
5. Construire un decoder minimal
function decodeJwt(input) {
  const token = normalizeJwtInput(input);
  const parts = token.split(".");
  if (parts.length !== 3) throw new Error("JWT signé à 3 segments attendu");

  return {
    token,
    header: decodeJwtJson(parts[0], "JWT header"),
    payload: decodeJwtJson(parts[1], "JWT payload"),
    signature: parts[2]
  };
}
À ce stade je peux lire alg, kid, iss, aud, exp. Je n'ai toujours pas vérifié la signature.
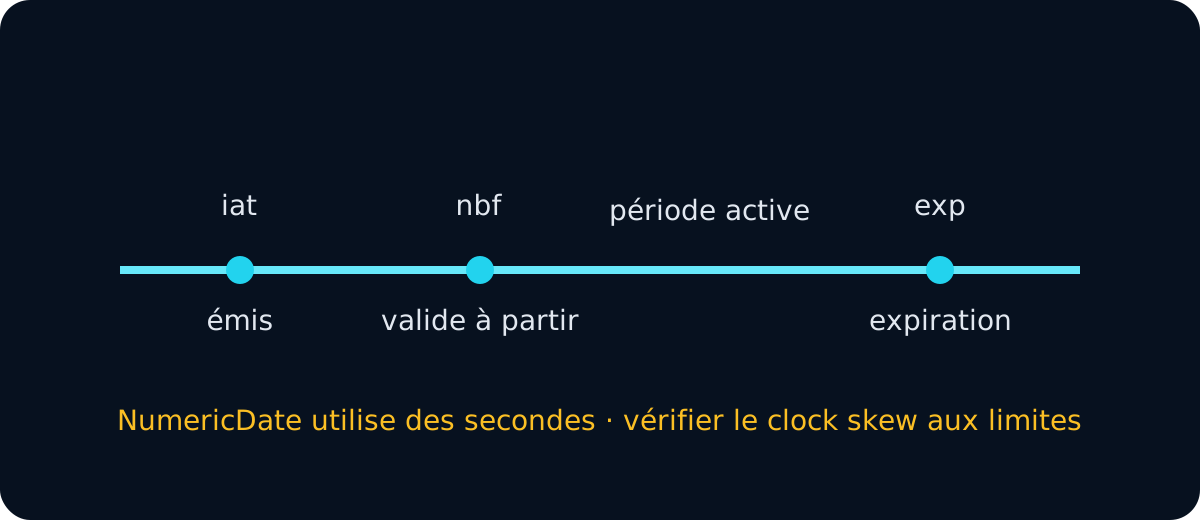
6. exp : secondes contre millisecondes
function getExpiration(payload) {
  if (typeof payload.exp !== "number") return { hasExpiration: false };
  return {
    hasExpiration: true,
    expiresAt: new Date(payload.exp * 1000),
    expired: Date.now() >= payload.exp * 1000
  };
}
Je n'écris pas :
Date.now() >= payload.exp
Pour une timeline complète, j'utilise JWT Expiry Checker.
Node.js : j'utilise parfois Buffer
function decodeBase64UrlJson(segment) {
  return JSON.parse(Buffer.from(segment, "base64url").toString("utf8"));
}
Sur un serveur qui authentifie des requêtes, ce code d'inspection n'est jamais ma seule protection. J'utilise une bibliothèque JOSE/JWT avec signature, issuer, audience et algorithm policy.
jwt-decode reste un decoder
import { jwtDecode } from "jwt-decode";

const payload = jwtDecode(token);
const header = jwtDecode(token, { header: true });
La documentation de la bibliothèque sépare elle aussi decode et validation. Je ne l'utilise pas comme authentication gate côté serveur.
Pourquoi j'évite le one-liner classique
JSON.parse(atob(token.split(".")[1]));
Il :
- suppose que le payload existe ;
- traite mal la différence Base64/Base64URL ;
- masque le padding ;
- peut casser UTF-8 ;
- donne de mauvaises erreurs ;
- ignore
algetkid; - fait oublier que la signature n'est pas vérifiée.
Après decode, il reste verify et validate
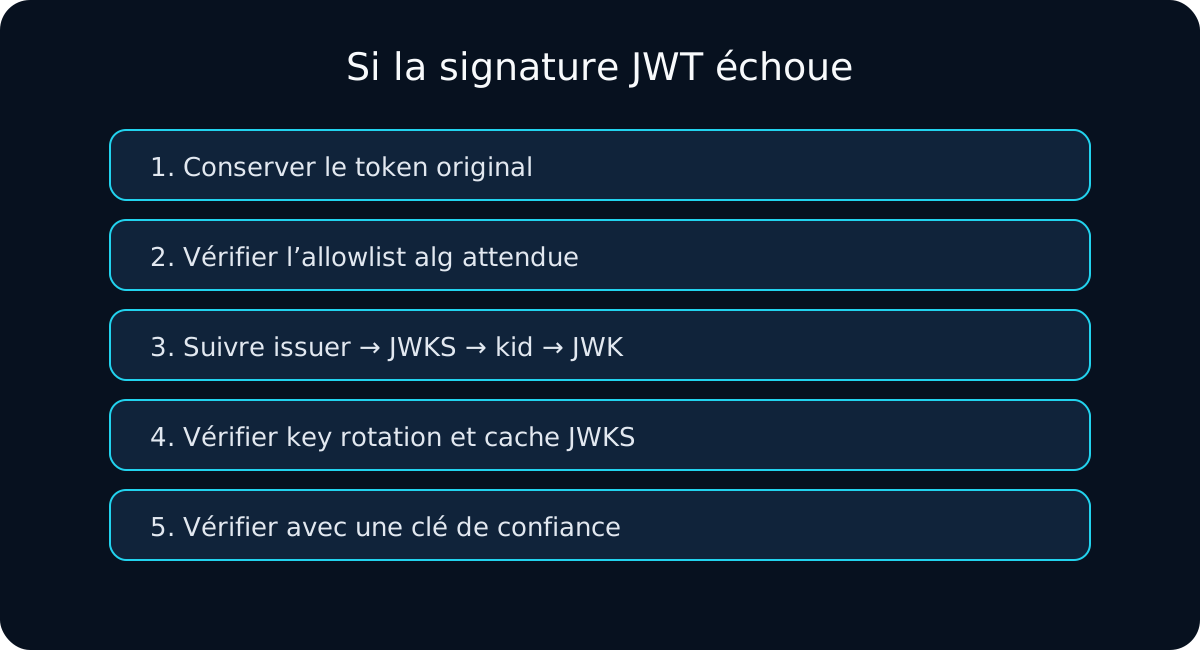
Pour l'authenticité, je passe au JWT Signature Verifier ou au JWKS Validator.
Puis je contrôle iss, aud, exp, nbf, token type, scopes et rôles dans JWT Validator ou JWT Debugger.
Mes règles de confidentialité côté navigateur
- pas de JWT dans l'URL ;
- pas de bearer token complet dans les logs ;
- pas de stockage persistant inutile pour le debugging ;
- tokens synthétiques/redacted privilégiés ;
- pas d'envoi serveur uniquement pour décoder Base64URL.
Ma checklist JavaScript
- Nettoyer Bearer.
- Vérifier les segments.
- Base64URL → bytes.
- Bytes → UTF-8.
- Parser header/payload proprement.
- Lire
alg,kid,iss,aud, temps. - Multiplier NumericDate par 1000 pour JavaScript.
- Marquer le résultat decoded, jamais verified.
- Vérifier la signature si la confiance compte.
- Valider issuer, audience, temps, type et permissions si l'acceptation compte.
Le point d'ingénierie essentiel est de garder séparés readable, cryptographically verified et acceptable par mon application.