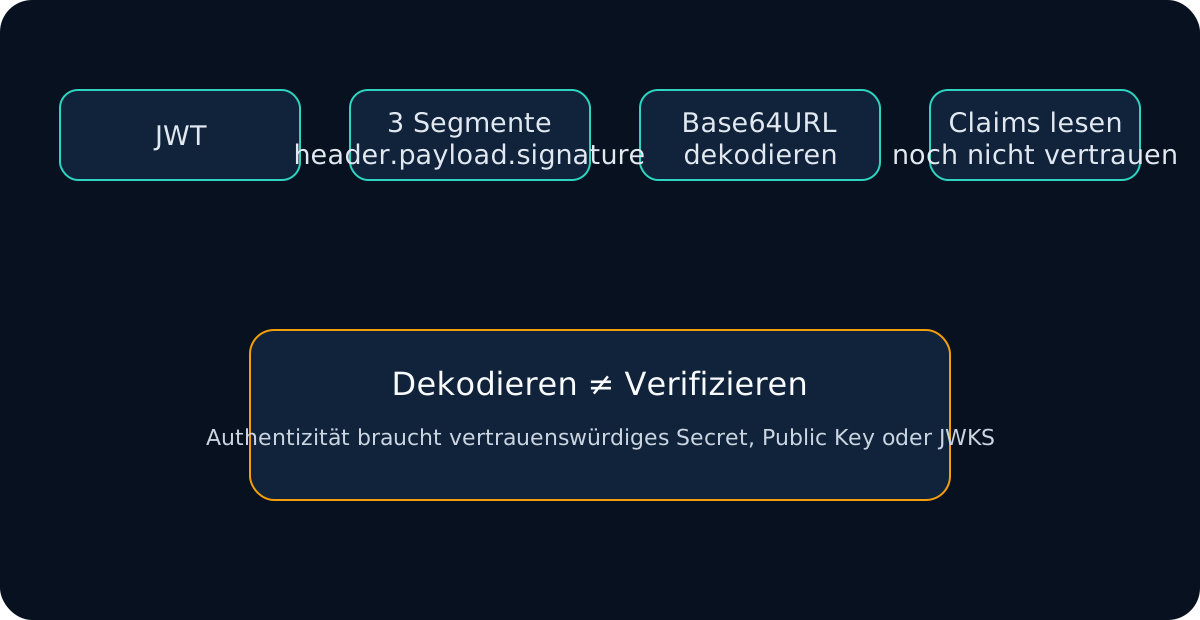
Wenn ich ein JWT in JavaScript dekodiere, setze ich zuerst eine klare Grenze: Dekodierung ist Inspektion, keine Authentifizierung. Ein erfolgreiches JSON.parse() macht das Token nicht vertrauenswürdig.
Für eine schnelle Sichtung nutze ich den JWT Decoder. Im eigenen Code gehe ich in sechs Schritten vor.
Meine sechs Schritte
BeareroderAuthorization: Bearerentfernen.- Segmentanzahl prüfen.
- Base64URL korrekt in Bytes umwandeln.
- Bytes als UTF-8 dekodieren.
- JSON mit getrennten Fehlern parsen.
- Claims wie
explesen, aber Signature Verification separat halten.
1. Input normalisieren
function normalizeJwtInput(input) {
  return input
    .trim()
    .replace(/^authorization\s*:\s*bearer\s+/i, "")
    .replace(/^bearer\s+/i, "")
    .trim()
    .replace(/^['"]|['"]$/g, "");
}
Damit arbeitet der restliche Decoder immer mit dem compact token.
2. Segmente prüfen
function splitSignedJwt(input) {
  const token = normalizeJwtInput(input);
  const parts = token.split(".");

  if (parts.length === 5) throw new Error("Sieht nach einem verschlüsselten JWE aus");
  if (parts.length !== 3) throw new Error(`Erwartet: 3 Segmente, erhalten: ${parts.length}`);
  return parts;
}
Ich greife nicht blind auf token.split('.')[1] zu.
3. Base64URL bewusst behandeln
JWT verwendet URL-safe Alphabet und oft kein Padding.
function base64UrlToBytes(segment) {
  const base64 = segment.replace(/-/g, "+").replace(/_/g, "/");
  const padded = base64.padEnd(
    base64.length + ((4 - (base64.length % 4)) % 4),
    "="
  );
  const binary = atob(padded);
  return Uint8Array.from(binary, c => c.charCodeAt(0));
}
atob() löst UTF-8 nicht automatisch.
4. UTF-8 vor JSON
function decodeJwtJson(segment, label) {
  let text;
  try {
    text = new TextDecoder("utf-8", { fatal: true })
      .decode(base64UrlToBytes(segment));
  } catch {
    throw new Error(`${label} ist kein gültiges Base64URL/UTF-8`);
  }

  let value;
  try {
    value = JSON.parse(text);
  } catch {
    throw new Error(`${label} ist kein gültiges JSON`);
  }

  if (!value || typeof value !== "object" || Array.isArray(value)) {
    throw new Error(`${label} muss ein JSON-Objekt sein`);
  }
  return value;
}
ASCII-only Testdaten verbergen UTF-8-Probleme leicht. Darum nutze ich TextDecoder explizit.
5. Kleinen Decoder zusammensetzen
function decodeJwt(input) {
  const token = normalizeJwtInput(input);
  const parts = token.split(".");
  if (parts.length !== 3) throw new Error("3-teiliges signiertes JWT erwartet");

  return {
    token,
    header: decodeJwtJson(parts[0], "JWT header"),
    payload: decodeJwtJson(parts[1], "JWT payload"),
    signature: parts[2]
  };
}
Jetzt kann ich alg, kid, iss, aud, exp lesen. Die Signatur ist noch nicht verified.
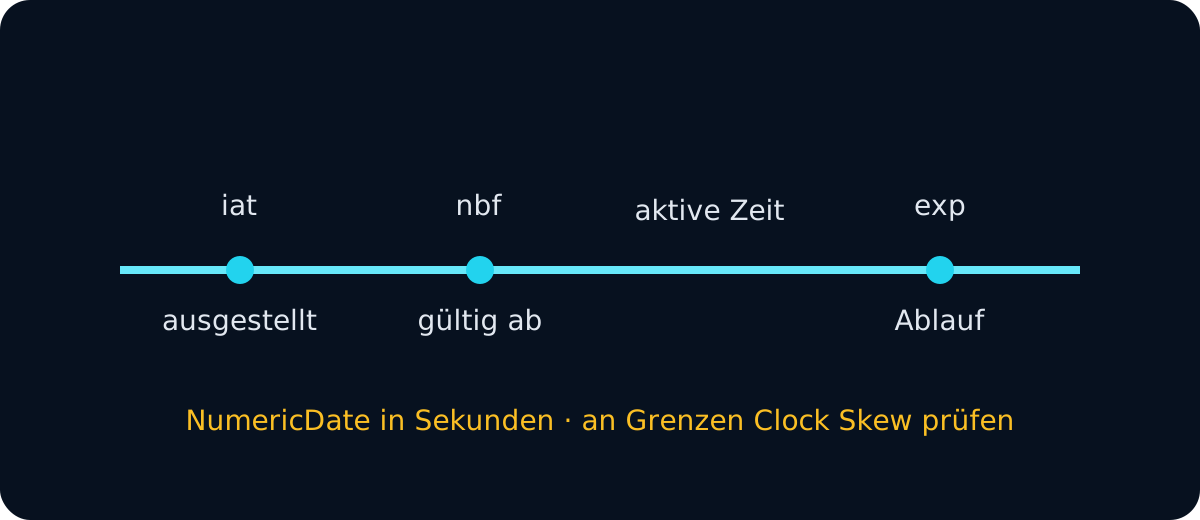
6. exp: Sekunden gegen Millisekunden
function getExpiration(payload) {
  if (typeof payload.exp !== "number") return { hasExpiration: false };
  return {
    hasExpiration: true,
    expiresAt: new Date(payload.exp * 1000),
    expired: Date.now() >= payload.exp * 1000
  };
}
Falsch wäre:
Date.now() >= payload.exp
Für eine schnelle Timeline nutze ich den JWT Expiry Checker.
Node.js mit Buffer
function decodeBase64UrlJson(segment) {
  return JSON.parse(Buffer.from(segment, "base64url").toString("utf8"));
}
Für echte Server-Authentifizierung nutze ich trotzdem eine JWT/JOSE-Bibliothek, die Signature, Issuer, Audience und Algorithm Policy prüft.
jwt-decode ist ebenfalls nur Decode
import { jwtDecode } from "jwt-decode";

const payload = jwtDecode(token);
const header = jwtDecode(token, { header: true });
Die Library selbst macht klar, dass Dekodierung keine Validierung ist. Ich setze sie daher nicht als Authentication Gate ein.
Warum ich den Einzeiler vermeide
JSON.parse(atob(token.split(".")[1]));
Er:
- setzt ein vorhandenes Payload-Segment voraus;
- behandelt Base64URL nicht bewusst;
- versteckt Padding-Probleme;
- kann UTF-8 falsch behandeln;
- liefert schwache Fehlerdiagnose;
- ignoriert Header mit
alg/kid; - verleitet dazu, Signature Verification zu vergessen.
Nach Decode folgen Verify und Validate
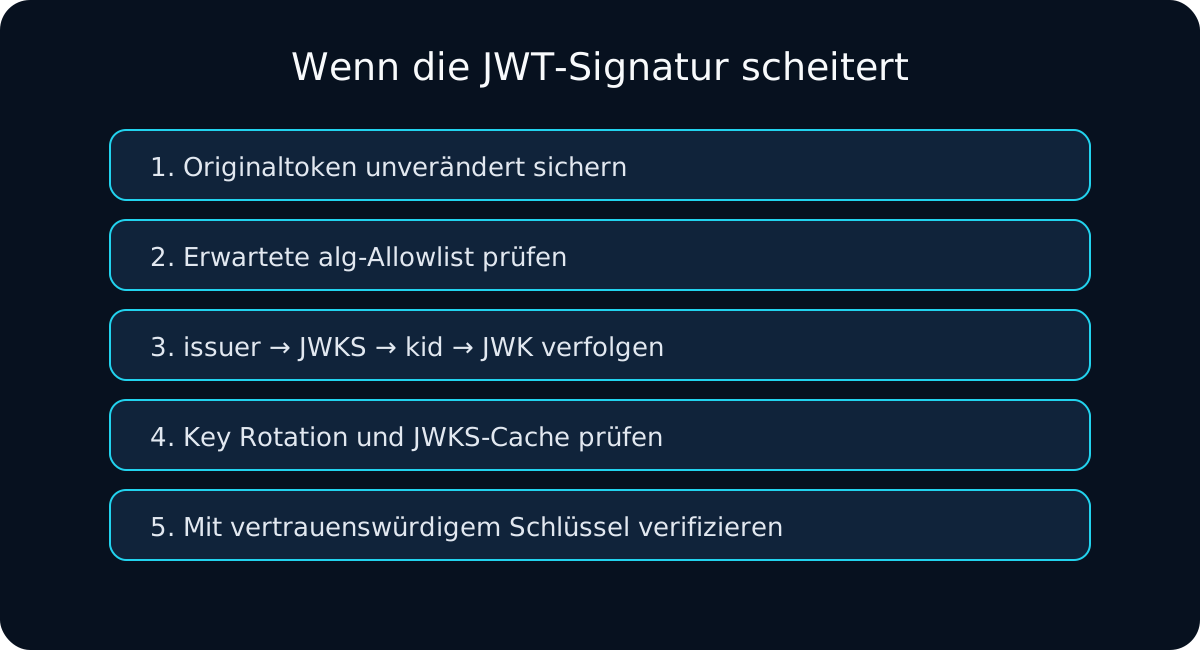
Für Authentizität gehe ich zu JWT Signature Verifier oder JWKS Validator.
Danach prüfe ich iss, aud, exp, nbf, Token-Typ und Permissions mit JWT Validator oder JWT Debugger.
Meine Browser-Regeln
- JWT nicht in URLs schreiben.
- Production Bearer Token nicht vollständig loggen.
- Debug Tokens nicht unnötig persistent speichern.
- Synthetische/redigierte Tokens bevorzugen.
- Token nicht nur zum Base64URL-Decode an einen Server senden.
Meine JavaScript-Checkliste
- Bearer Prefix entfernen.
- Segmente prüfen.
- Base64URL → Bytes.
- UTF-8 dekodieren.
- Header/Payload sicher parsen.
alg,kid,iss,aud, Zeit prüfen.- NumericDate × 1000 für JS-Date.
- Ergebnis als decoded, nicht verified markieren.
- Bei Trust Signature mit bekanntem Key prüfen.
- Für Acceptance Issuer, Audience, Zeit, Typ und Permissions validieren.
Die wichtigste Engineering-Entscheidung ist für mich, readable, cryptographically verified und application-acceptable getrennt zu halten.